
在前一天,我們從 Worker Node 的角度看過 Pod 被 Scheduler 分派後,kubelet、Container Runtime 與 CNI 如何處理,藉此了解 Pod 如何被派送到一台 Node 上運作。
不過直至目前第七天,前面的文章中已經出現不少名詞:containerd、Volume、CRI、CNI、CSI...等,我想在今天先針對 CRI、CNI、CSI 這三個介面先進行說明,因為這三個也是 Kubernetes 底層運作中很重要的一部份,藉此更了解 Pod 在運作時還需要哪些服務,未來若 Pod 碰到異常,也可以透過錯誤訊息來了解是哪一個介面的服務發生錯誤,縮小錯誤的排查範圍。
其實 Kubernetes 更像是一個負責協調的平台:它定義與呼叫標準介面,而真正處理 container、網路與儲存細節的是這些介面的不同實作。
CRI、CNI、CSI 分別是:
| 簡稱 | 全名 | 用途 |
|---|---|---|
| CRI | Container Runtime Interface | 讓 kubelet 能要求 Runtime 拉取 image、建立並管理 Pod 的 container。 |
| CNI | Container Network Interface | 讓 Runtime 能請網路外掛替 Pod 接上網路、配置 IP 與路由。 |
| CSI | Container Storage Interface | 讓 Kubernetes 能透過不同的儲存 Driver,將外部儲存系統或可由 Node 掛載的儲存空間,提供給 Pod 使用。 |
這三個都是介面,所以實際上的服務是由各種不同的實作套件在運作。就像是程式開發的 DI 依賴注入,Kubernetes 定義了標準介面,而不同的實作套件就像不同的 Service 實作,並依據不同需求可以選擇不同套件或是切換。
不過雖然表面上看起來抽換服務是一件很單純的事情,替換 CRI、CNI 或 CSI 都可能牽涉每台 Node、既有網路、已掛載資料與版本相容性,就像是後端程式可以抽換不同的資料庫服務,但實際上抽換後還是得針對相依的服務去驗證與測試,確保服務都能正常。
甚至也有一些實作要抽換時,是需要一一重啟每台 Node 上的相關服務或是整台 Node,如此當下服務可能會不穩定或是可用資源變少,Node 的重啟也不會像 Pod 那麼迅速(當然不可能直接在正式環境上直接不驗證就做這種事,想表達的是這其實是一個大工程 XD)。
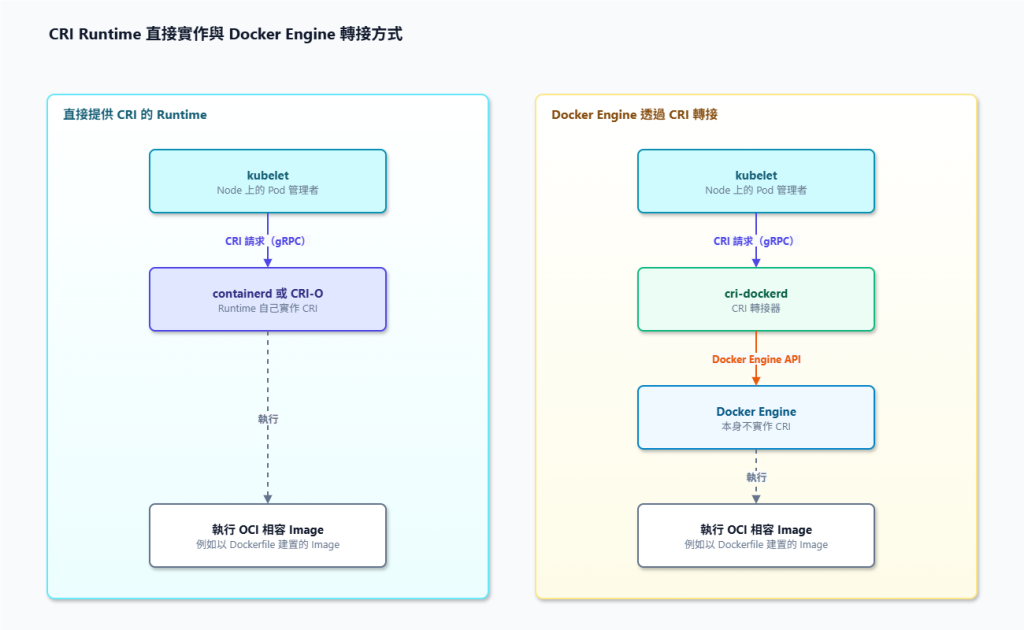
CRI 是 kubelet 與 Container Runtime 之間的溝通協議。
kubelet 知道某一個 Pod 已被指派到本機,也看得懂 PodSpec,但它不應該直接綁定某一套 Runtime 的內部 API。因此 kubelet 會以 CRI 的 gRPC 協議,向本機 Runtime 提出像是「確認 image」、「建立 Pod 執行環境」、「建立 container」、「啟動或停止 container」等要求。Kubernetes 官方將 CRI 定義為 kubelet 與 Container Runtime 溝通的主要 gRPC 協議。
常見的 CRI 相容 Runtime 包括:
containerd:一套通用且常見的 Container Runtime。CRI-O:專門以 Kubernetes CRI 為目標的 Container Runtime。當 kubelet 收到一份已分派到本機的 PodSpec,大概會跑這樣的流程:
kubelet
  │  CRI 請求
  ▼
Container Runtime
  ├─ 確認或拉取 image
  ├─ 準備 Pod 的執行環境與必要設定
  ├─ 配合 CNI 建立 Pod 網路
  └─ 建立並啟動 Pod 所需的 container
在 CRI 的語言中,Runtime 會先建立 Pod Sandbox。簡單說就是 Runtime 為一個 Pod 準備好的底層執行環境,尤其包含該 Pod 所需的網路設定與隔離邊界。
CRI 常會連同 OCI 一起出現,我自己也是蠻常搞混的,所以也順便說明,加強記憶一下:
平常以 Dockerfile 建置 Image 是相容於 OCI 規格的,所以可以由 containerd、CRI-O 等 Runtime 啟動容器,不一定需要 Docker Engine。
這也是在 Kubernetes 1.23 移除 Docker shim 後,既有 Image 仍然可以繼續使用的原因。因為被移除的是 Kubernetes 內建用來轉接給 Docker Engine 的 dockershim。若想要繼續使用 Docker Engine 作為 Kubernetes 的 Runtime,就必須要額外透過 cri-dockerd 這個 CRI 轉接器達到讓 Docker Engine 能夠與 kubelet 溝通的目的。
Docker Engine 並不是 CRI,而是透過
cri-dockerd這類 CRI 轉接器與 kubelet 溝通。
CNI 是 Container Runtime 與網路實作之間的協作方式。
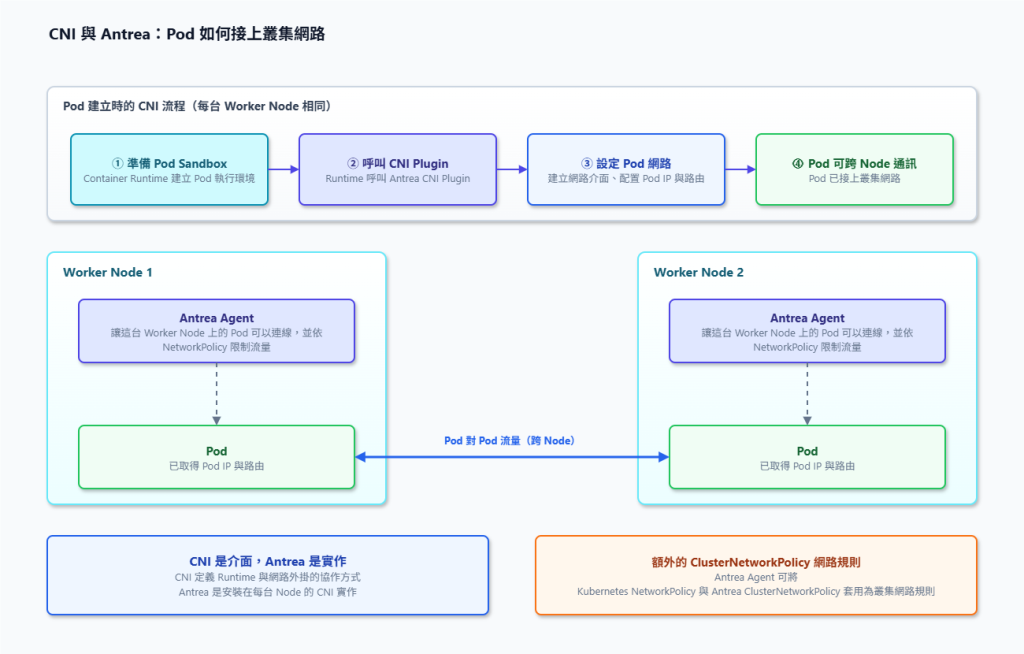
Pod 裡的應用即使已經被 Runtime 啟動,如果沒有網路介面、IP、路由以及網路規則,仍無法正常與其他系統通訊。CNI 定義的正是 Container Runtime 與叢集網路之間的協作方式,這套 CNI 實作會安裝在叢集各個 Node 上,負責讓新建立的 Pod 取得網路介面與 IP,並能和其他 Node 上的 Pod 通訊。
當 Runtime 準備 Pod Sandbox 時,會呼叫 CNI Plugin,Plugin 依需求在 Node 與 Pod 的網路環境建立介面、配置 Pod IP、設定路由,並在 Pod 結束時也會負責回收這些的資源。Kubernetes 要求叢集需使用符合 CNI 規格的網路外掛,才能正常運作 Pod 的網路服務。
常見的 CNI 實作有:
Antrea:以 Open vSwitch 為基礎的 Kubernetes 網路與安全方案。Cilium:以 eBPF 為核心的網路、可觀測性與安全方案。Calico:常見的 Kubernetes 網路與 NetworkPolicy 實作。以 Antrea 來說,當 CNI Plugin 被 Runtime 呼叫時,它會協助 Pod 接上叢集網路,但 Antrea 不只有這個被呼叫的 Plugin,它也會在每一台 Node 上運行 Antrea Agent,將叢集的網路設定落地到該 Node。
例如,Agent 能處理 Kubernetes 原生的 NetworkPolicy,也能處理 Antrea 提供的 ClusterNetworkPolicy。後者是 Antrea 的擴充資源,不是 Kubernetes 核心內建的 API,這些規則最終會決定哪些 Pod 流量可以被允許或拒絕。
也要避免把 Envoy 當成 CNI,Envoy 是處理既有 TCP、HTTP 或 gRPC 流量的 L4/L7 Proxy,常用於 Service Mesh 或 Gateway,它不負責替 Pod 建立網卡與 Pod IP,這也是有可能會誤會的地方。
CSI 讓 Kubernetes 能以一致的方式,請不同儲存系統的 Driver 提供、掛載與卸載 Volume。
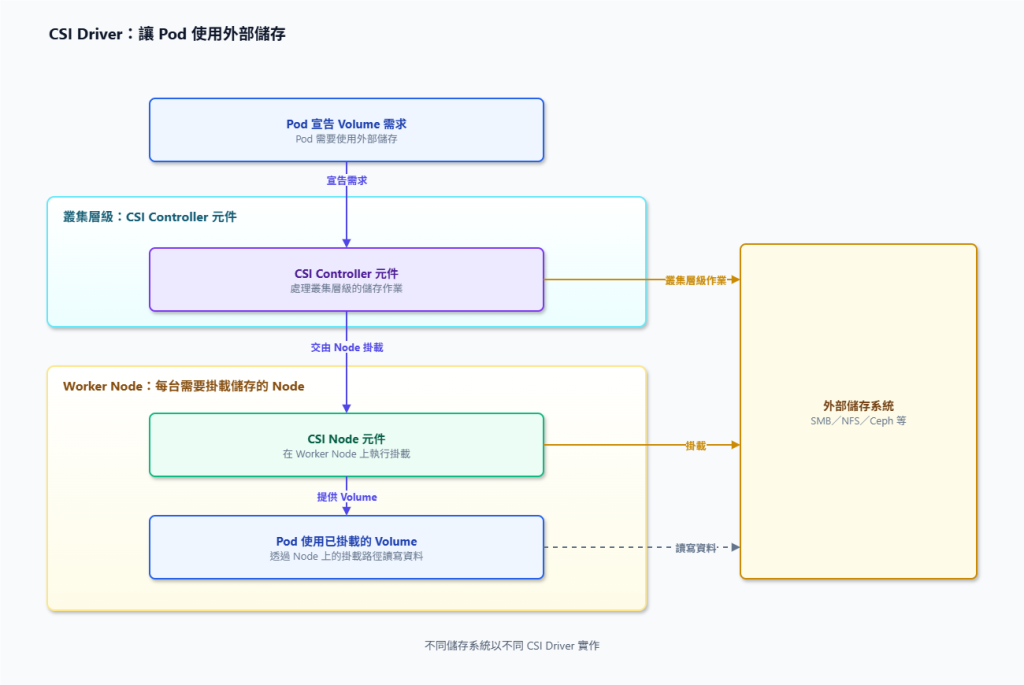
container 內的資料會隨著 container 被刪除時一起消失,若需要保存資料到容器外(通常是 log 這種檔案,不是 appsettings.json 等 config 類型檔案),在 Docker 環境時我們會透過設定 Volume 去掛載到 Host 主機的指定目錄,藉此將資料保存在容器外避免一起消失,而在 Kubernetes 中,這件事情需要由 CSI 的實作來達成。
常見的 CSI Driver 包括:
SMB CSI Driver:讓 Pod 能以 Volume 使用 SMB 檔案分享。NFS CSI Driver:提供 NFS 類型的 Volume 使用方式。Ceph CSI:連接 Ceph 提供的區塊、檔案或其他儲存能力。CSI Driver 通常不只是單一程式,它會有處理叢集層級的 Controller 元件,以及部署在每台需要掛載儲存的 Node 上的 Node 元件,後續介紹 StorageClass、PV、PVC 與掛載生命週期時,就會看到它們如何與 CSI Driver 協作。
實際派發 Pod 時,三個介面處理的流程可以這麼理解:
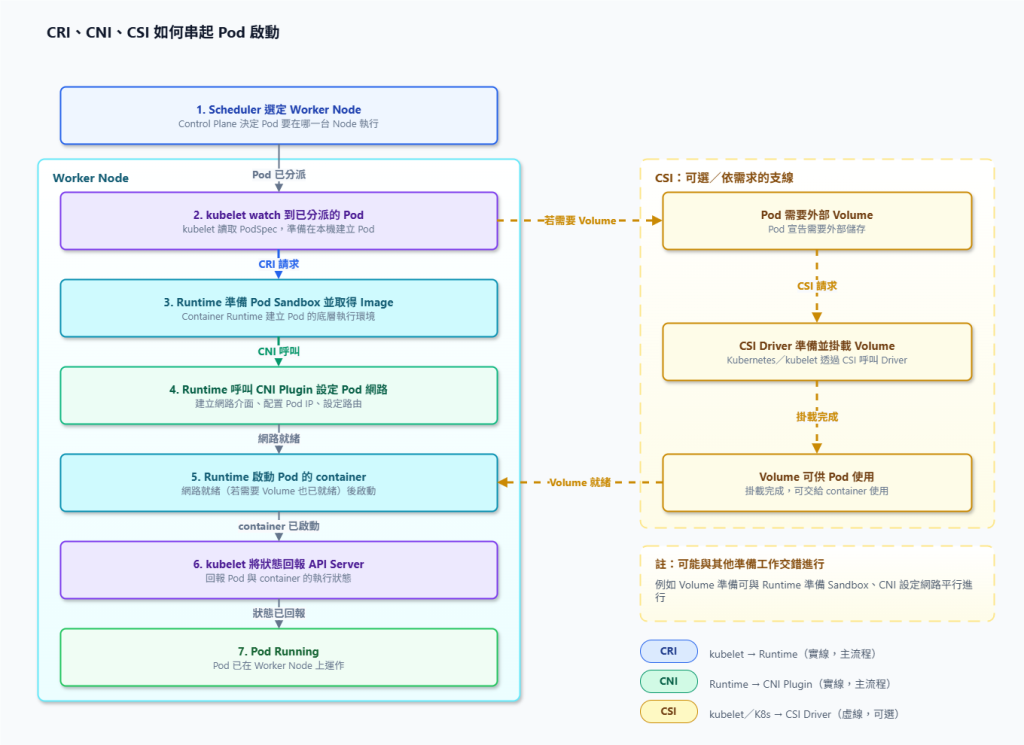
實際上這個流程可能會是平行在進行的,例如 Volume 的準備與 Runtime 的處理可能平行進行,這邊的寫法算是方便理解
CRI、CNI、CSI 讓 Kubernetes 不必綁定某一個 Container Runtime、網路方案或儲存設備,它們將 Kubernetes 的控制邏輯與底層實作分開:kubelet 用 CRI 請 Runtime 執行 Pod;Runtime 用 CNI 讓 Pod 接上網路;Kubernetes 與 kubelet 則可透過 CSI 使用不同的儲存 Driver 獲得不同的儲存能力。


 iThome鐵人賽
 看影片追技術